Arbeidsflyten kan vente og fortsette uten at brukeren holder nettleseren åpen. Illustrasjon generert med OpenAI Images.

En agent som skal jobbe videre uten en åpen chat, må kunne vente på godkjenning og fortsette etter feil. Med en supportagent som eksempel viser jeg hvordan durable execution med Temporal hjelper oss å håndtere dette, og hvilke arkitekturvalg som følger med.
Jeg prøvde durable execution, altså kodekjøring som lagrer fremdrift og kan gjenopptas etter et krasj, i et av mine personlige prosjekter. Jeg ble overrasket over hvor god abstraksjon det var for nettopp agentiske arbeidsflyter. Jeg kunne uttrykke venting i vanlig kode, konfigurere retries og se hva hver kjøring holdt på med. Det gjorde det lettere å bygge videre på agenten.
Samtidig kjente jeg igjen behovene fra et kundeprosjekt på jobb. Der bygde vi deler av denne funksjonaliteten selv, på infrastrukturen vi allerede hadde. Erfaringen fra fritidsprosjektet gjorde det tydeligere hvor mye arbeid en slik motor kan ta ansvar for.
Hvis du allerede har en fungerende agent, kommer du før eller siden til et praktisk spørsmål. Hva må endres når agenten skal arbeide uten en åpen chat?
Disclaimer: I denne posten bruker jeg hovedsakelig Temporal til å vise hvordan durable execution kan brukes for AI-agenter. Temporal kan selvhostes, og det kan også Inngest og Trigger.dev. AWS Step Functions er en administrert AWS-tjeneste. Selvhosting gir kontroll over driften, men bytte av motor krever selvfølgelig kodeendringer.
For å gjøre spørsmålet konkret kan vi følge en agent i et fiktivt saksbehandlingssystem. En ansatt melder at VPN-tilkoblingen ikke fungerer. Agenten leser saken, finner en relevant kunnskapsartikkel og foreslår et svar som en saksbehandler kan godkjenne.
Agenten bruker saksbehandlings-API-et til å lese og oppdatere selve saken. API-et kontrollerer tilgang og sørger for at endringene lagres etter systemets regler.
Dette fungerer fint lokalt. Du starter programmet, følger kjøringen og ser resultatet. Nå vil du at produktet skal starte agenten automatisk når en ny sak kommer inn, også når ingen har saksbehandlingssystemet åpent.
Når agenten skal settes i produksjon, trenger vi å avklare disse delene av løsningen:
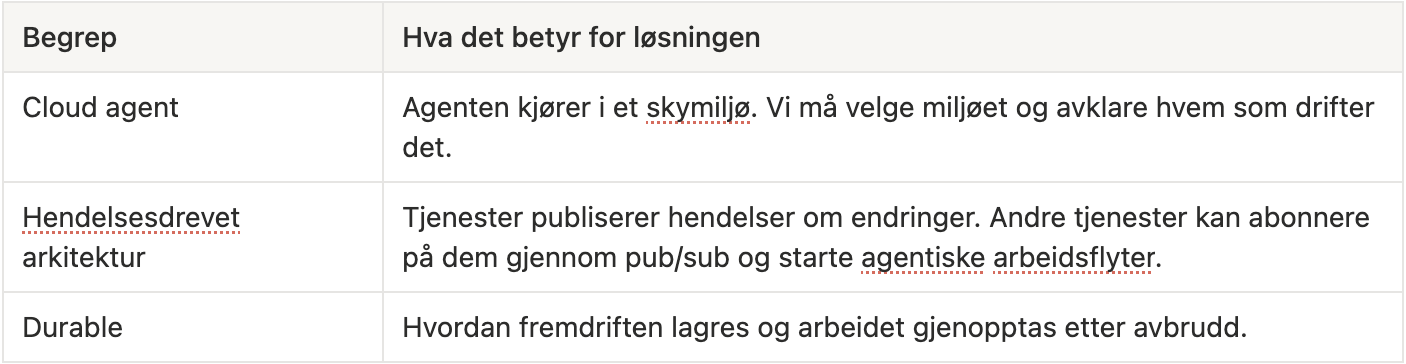
En hendelse kan altså starte supportagenten i skyen. For at arbeidet skal fortsette etter et krasj, trenger vi også lagret fremdrift og en mekanisme for gjenopptakelse. Vi må derfor velge hvilke avbrudd produktet skal tåle, uansett hvor agenten kjører.
Når denne agenten skal bli en del av produktet, trenger den en måte å få arbeid på. I eksempelet publiserer saksbehandlingssystemet en TicketCreated-hendelse når en ny sak opprettes. En consumer tar imot hendelsen og starter agenten i en worker. Da kan arbeidet fortsette uavhengig av nettleseren brukeren befinner seg i.
Dette kan være et godt sted å begynne. Har dere allerede en kø og et system for bakgrunnsjobber, er det mye å hente der. Men dere må forstå konfigurasjonen. Celery, som er et system for købaserte bakgrunnsjobber i Python, har for eksempel egne valg for når meldinger bekreftes. Det har også innstillinger for hvordan tap av en worker skal håndteres. Celery dokumenterer disse forskjellene.
Jobben må likevel tåle at workeren stopper under en deploy. Hvis modellen allerede har svart, men resultatet bare finnes i minnet, går svaret tapt. Ved et nytt forsøk må dette arbeidet gjentas, mens registrerte resultater kan gjenbrukes. Applikasjonen må derfor lagre fremdriften og resultatene som skal gjenbrukes, slik at de overlever at workeren stopper. Da kan en ny worker se hva som er fullført og fortsette arbeidet.
Når samme hendelse kan komme flere ganger, trenger arbeidet en ID som holder seg lik. For supportagenten knytter vi det første svaret til kunden og saken.
Med Temporal kan vi gjøre dette ved å velge en workflowId når vi starter arbeidsflyten. TypeScript-koden under bruker Temporal-klienten. Den forutsetter en tilkoblet Client og en worker som tilbyr supportTicketWorkflow på køen support-agents:
import {
  type Client,
  WorkflowExecutionAlreadyStartedError,
  WorkflowIdConflictPolicy,
  WorkflowIdReusePolicy,
} from "@temporalio/client";

export async function ensureTicketWorkflow(
  client: Client,
  event: { tenantId: string; ticketId: string },
) {
  // 👇🏽 Samme kunde og sak gir samme ID for det første svaret.
  const workflowId = `first-reply:${event.tenantId}:${event.ticketId}`;

  try {
    return await client.workflow.start("supportTicketWorkflow", {
      workflowId,
      taskQueue: "support-agents",
      args: [event],
      // 👇🏽 Bruk arbeidsflyten som allerede kjører.
      workflowIdConflictPolicy: WorkflowIdConflictPolicy.USE_EXISTING,
      // 👇🏽 Avvis ny start når arbeidsflyten er avsluttet.
      workflowIdReusePolicy: WorkflowIdReusePolicy.REJECT_DUPLICATE,
    });
  } catch (error) {
    if (error instanceof WorkflowExecutionAlreadyStartedError) {
      // 👇🏽 Hent arbeidsflyten som finnes fra før.
      return client.workflow.getHandle(workflowId);
    }
    throw error;
  }
}
Denne ID-en gjør at gjentatte hendelser finner det samme arbeidet. For avsluttede workflows gjelder beskyttelsen så lenge Temporal beholder historikken.
Før consumeren kan starte dette arbeidet, må hendelsen faktisk nå køen. Saksbehandlingssystemet kan lagre saken og krasje før TicketCreated publiseres. Da finnes saken, men consumeren får ingen beskjed om å behandle den.
For å håndtere dette kan vi bruke en transactional outbox. Da lagrer vi saken og en outbox-hendelse i samme databasetransaksjon. Enten lagres begge, eller ingen av dem. En separat relay leser upubliserte hendelser og sender dem til køen.
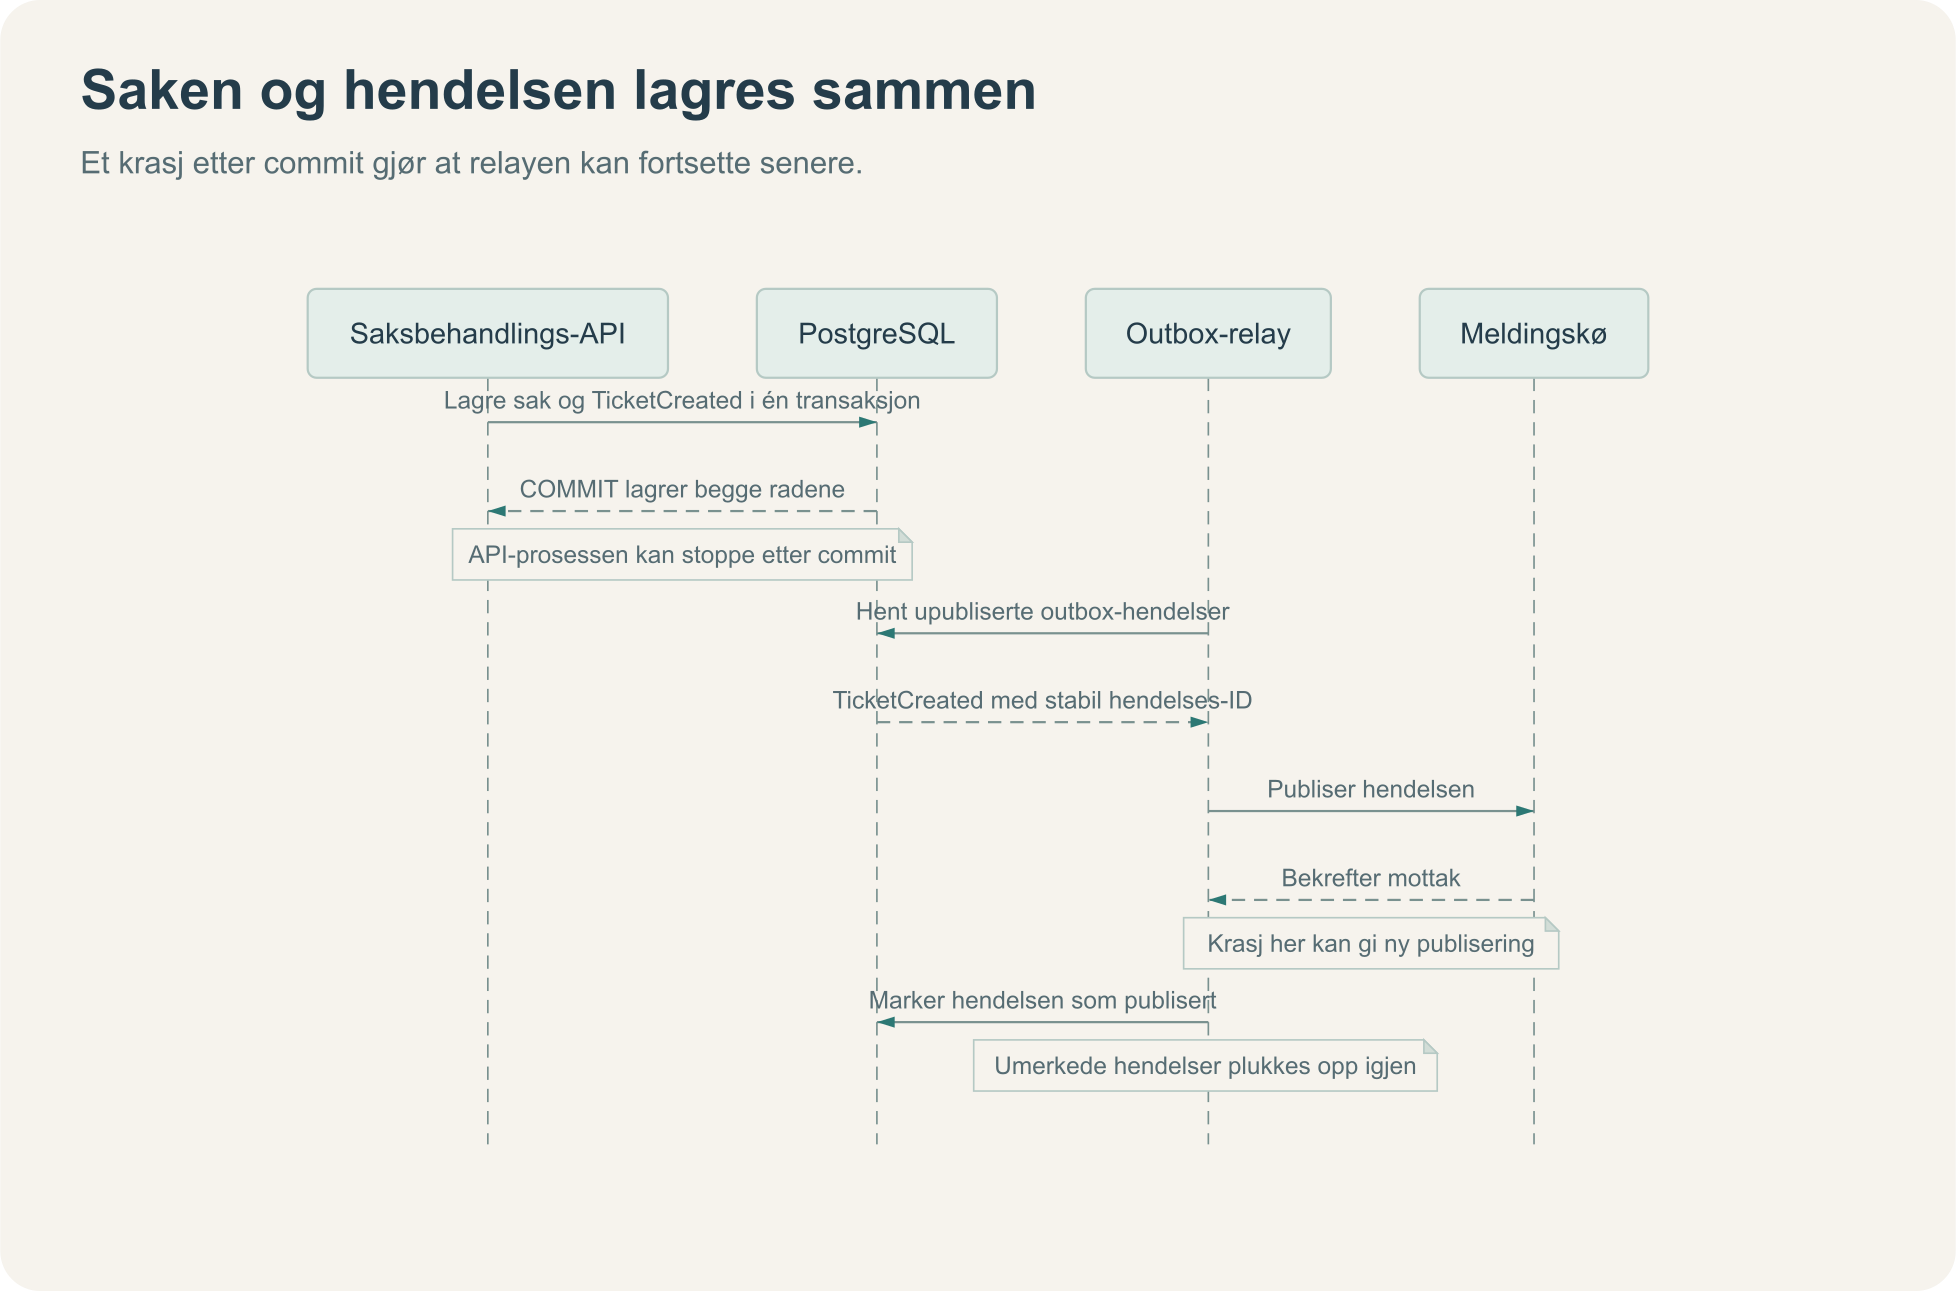
Relayen kan krasje etter publisering, før hendelsen markeres som publisert. Derfor må consumeren tåle duplikater. Den stabile Workflow ID-en over hjelper med å finne samme arbeid når hendelsen leveres på nytt.
Etter at agenten har laget svarforslaget, må en saksbehandler godkjenne det. Saksbehandleren har imidlertid gått for dagen, så agenten må vente. Arbeidsflyten skal fortsette når noen godkjenner eller avviser, eller når fristen går ut. Ventingen må overleve at workeren stopper.
Jeg likte å kunne uttrykke slik venting i kode med durable execution. Arbeidsflyten kan beholde en lesbar rekkefølge selv om det går lang tid mellom stegene. Her er samme forløp med Temporals TypeScript-SDK:
import {
  condition,
  defineSignal,
  proxyActivities,
  setHandler,
} from "@temporalio/workflow";
import type {
  ReplyDecision,
  SupportActivities,
  TicketCreated,
} from "./support-contracts";

// 👇🏽 Modell- og API-kall kjøres som Activities med avgrensede retries.
const { createReplyProposal, applyApprovedReply } =
  proxyActivities<SupportActivities>({
    startToCloseTimeout: "2 minutes",
    retry: { maximumAttempts: 3 },
  });

export const replyDecision = defineSignal<[ReplyDecision]>("replyDecision");

export async function supportTicketWorkflow(input: TicketCreated) {
  const proposal = await createReplyProposal(input);
  const state: { decision?: ReplyDecision } = {};

  // 👇🏽 Ta imot den første beslutningen for akkurat dette forslaget.
  setHandler(replyDecision, (decision) => {
    if (decision.proposalId === proposal.id && !state.decision) {
      state.decision = decision;
    }
  });

  // 👇🏽 Vent på en beslutning i opptil 48 timer, uten en opptatt worker-tråd.
  const received = await condition(() => state.decision !== undefined, "48h");

  // 👇🏽 Overlat saken til et menneske ved avvisning eller utløpt frist.
  if (!received || state.decision?.type !== "approved") {
    return { status: "needs-human" };
  }

  // 👇🏽 Be saksbehandlings-API-et kontrollere og bruke det godkjente forslaget.
  return applyApprovedReply({
    ...input,
    proposalId: proposal.id,
    expectedRevision: proposal.ticketRevision,
    operationId: proposal.replyOperationId,
  });
}
Backend kontrollerer saksbehandlerens tilgang før den sender replyDecision med forslagets ID og beslutningen. condition bruker en varig timer, så ventingen holder ingen worker-tråd opptatt.
createReplyProposal og applyApprovedReply er applikasjonens egne Activities og må implementeres og registreres på workeren. Typene i support-contracts.ts beskriver dataene de tar imot og returnerer.
Koden viser godkjenningsforløpet. applyApprovedReply må i tillegg rapportere hvis saken har endret seg eller tilgangen er borte, slik at produktet kan håndtere det.
For at koden skal kunne fortsette etter et avbrudd, skiller Temporal mellom Workflow og Activity. Workflow-koden beskriver fremdriften og må følge kravene til deterministisk replay. Modellkall og HTTP-kall legges i Activities. Workflow-definisjonen beskriver denne grensen.
Når en worker må gjenopprette en workflow, kjøres workflow-koden mot den lagrede hendelseshistorikken. Resultater fra ferdige, registrerte Activities brukes igjen. Modellen trenger derfor ikke kjøres på nytt for hvert fullført steg. Dette er replay, og det gjør den lagrede historikken til en del av kjøremodellen.
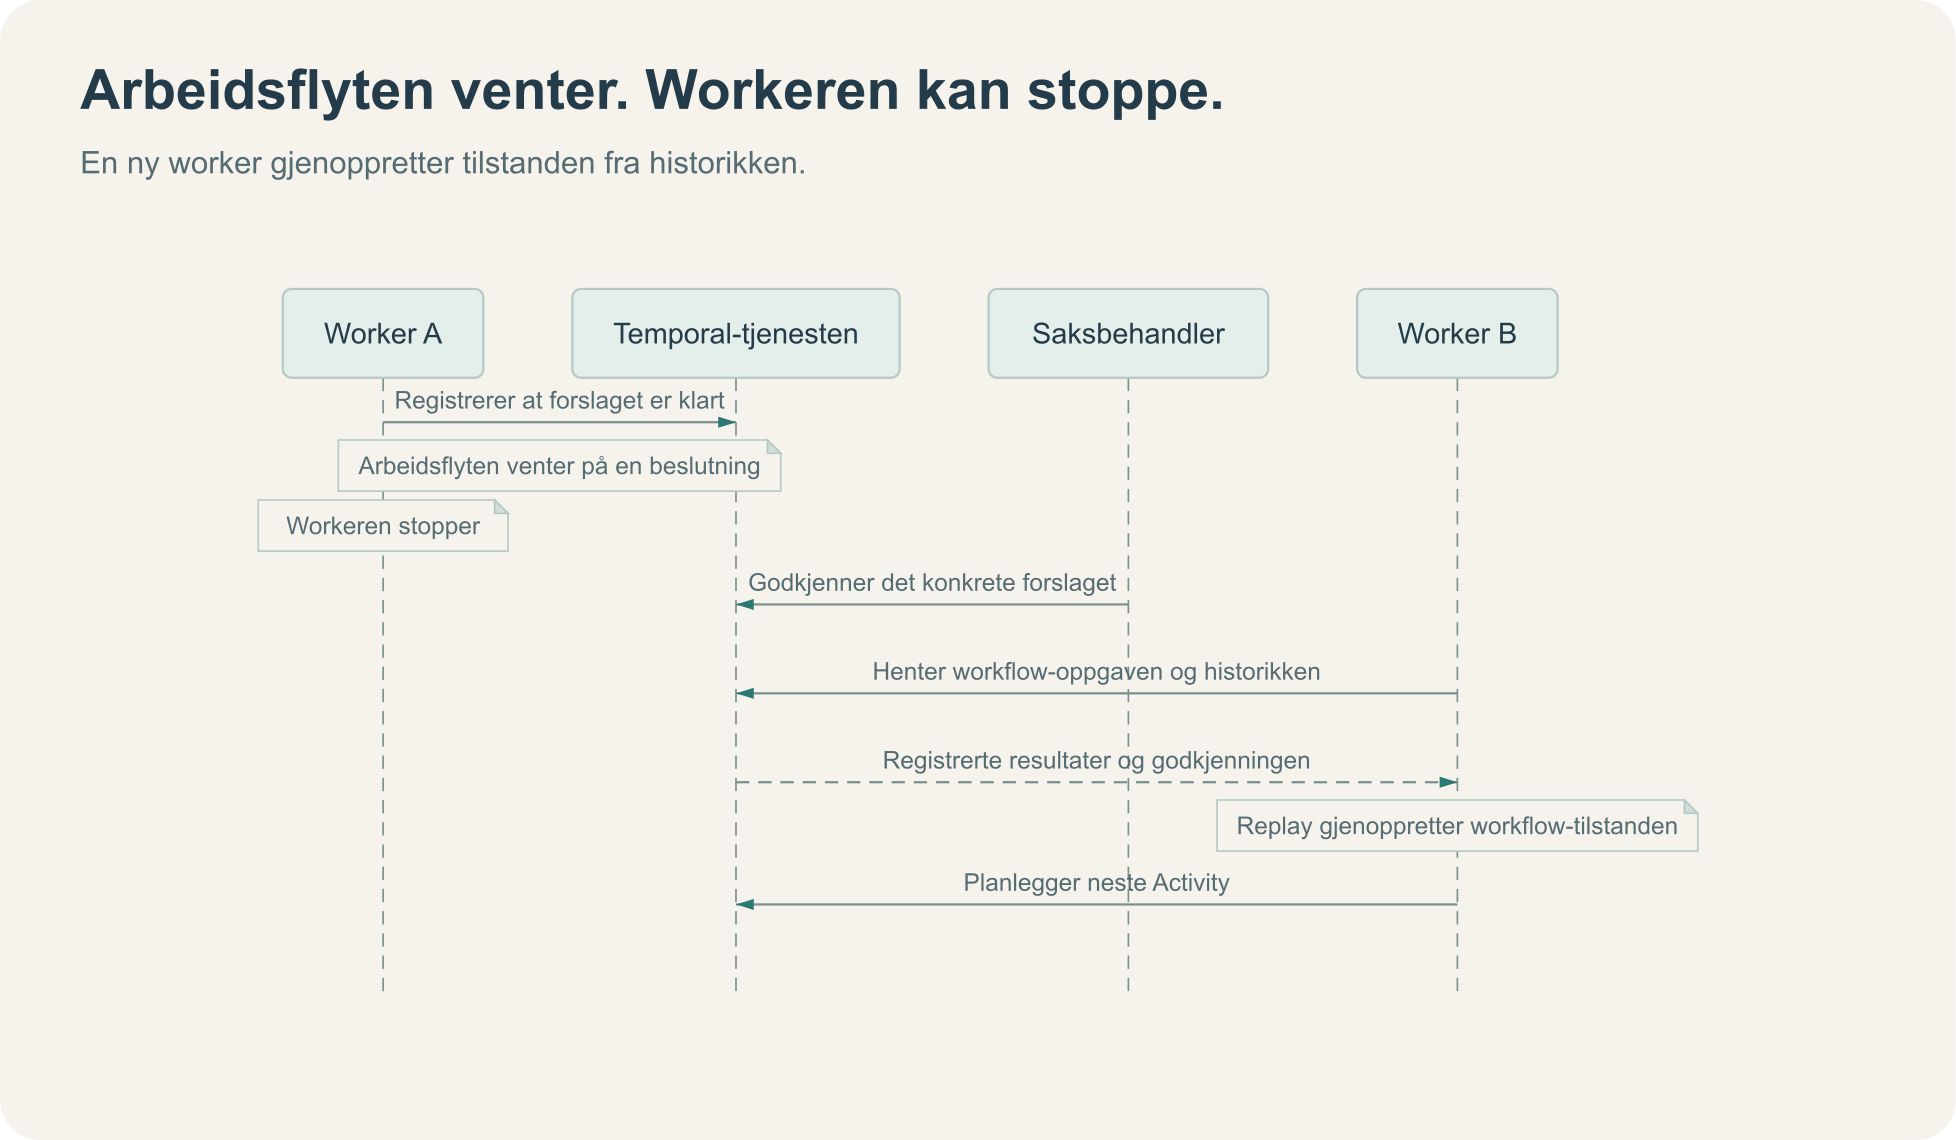
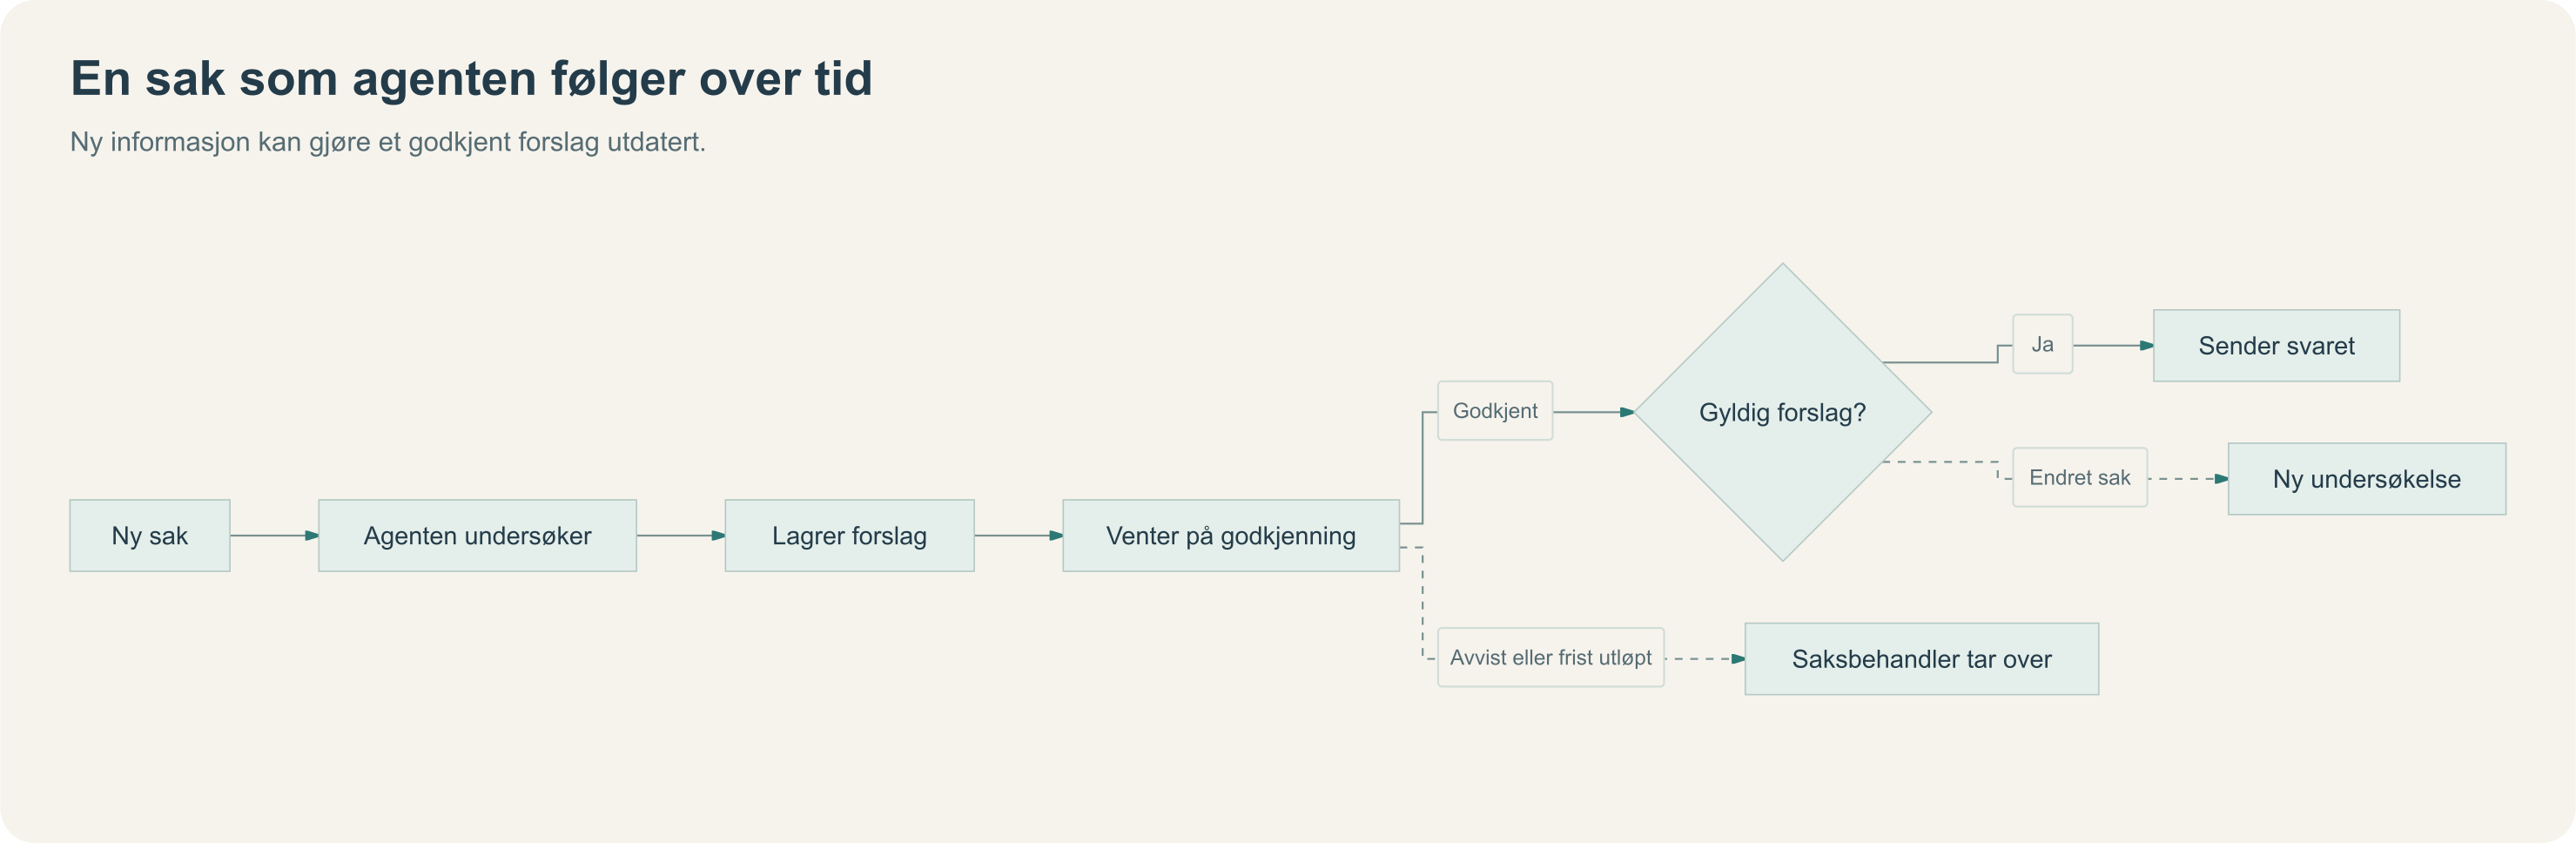
Mens agenten venter på godkjenning, legger den ansatte til et skjermbilde av feilmeldingen fra VPN-klienten i saken introdusert i starten av dette eksempelet. Feilmeldingen tyder på en annen årsak enn agenten først antok. Hvis saksbehandleren godkjenner det opprinnelige svarforslaget, risikerer agenten derfor å sende et svar basert på utdatert informasjon.
Godkjenningen må derfor gjelde ett konkret forslag og kildegrunnlaget for forslaget. I eksempelet sender vi med forventet saksrevisjon. Saksbehandlings-API-et kan kontrollere revisjonen atomisk når det skal lagre svaret. Har saken endret seg, må produktet velge om agenten skal undersøke på nytt eller overlate saken til et menneske.
Mens agenten venter på godkjenningen vi la inn over, kan også saksbehandlerens tilgang endre seg. Personen som kunne lese saken da forslaget ble laget, har kanskje mistet tilgangen når svaret skal sendes. Derfor må saksbehandlings-API-et kontrollere både tilgangen og saksrevisjonen når applyApprovedReply ber om å bruke forslaget.
Når slike endringer skal varsles med hendelser, trenger vi også regler for hvordan agenten reagerer. En duplikat TicketCreated skal normalt finne samme logiske arbeid. En TicketUpdated må knyttes til riktig sak og vurderes opp mot det agenten allerede gjør. Agentens egne endringer må heller ikke starte en endeløs rekke nye analyser.
For supportagenten kan regelen være at nye opplysninger gjør det eksisterende forslaget utdatert. Agenten må da vurdere saken på nytt, og saksbehandleren må godkjenne det oppdaterte forslaget før svaret kan sendes. Temporal hjelper oss å vente og fortsette kjøringen, men reglene for hva som skal skje når saken endrer seg, må vi fortsatt definere i produktet.
Etter en ny vurdering er forslaget oppdatert, og saksbehandleren godkjenner det. Nå kan agenten be saksbehandlings-API-et om å lagre svaret. Svaret blir lagret, men forbindelsen forsvinner før workeren får bekreftelsen.
Nå er utfallet ukjent for workeren. Et nytt forsøk kan utføre samme handling igjen. Temporal dokumenterer nettopp dette tilfellet og anbefaler at Activities er idempotente. Det betyr at gjentatte forsøk på samme operasjon gir samme forretningsresultat.
I vårt eksempel får svaret en stabil operasjons-ID før første forsøk. Saksbehandlings-API-et lagrer ID-en atomisk sammen med svaret. Ved et nytt kall med samme ID kan API-et returnere det opprinnelige utfallet.
I eksempelet vårt kan den første sendingen også ha endret saksrevisjonen. Når workeren prøver igjen med samme operasjons-ID, må saksbehandlings-API-et derfor kjenne igjen at svaret allerede er lagret. Ellers kan revisjonskontrollen vi la inn tidligere, avvise forsøket som utdatert selv om operasjonen faktisk lyktes. API-et skal da kontrollere tilgangen og returnere det lagrede utfallet hvis tilgangen fortsatt er gyldig.
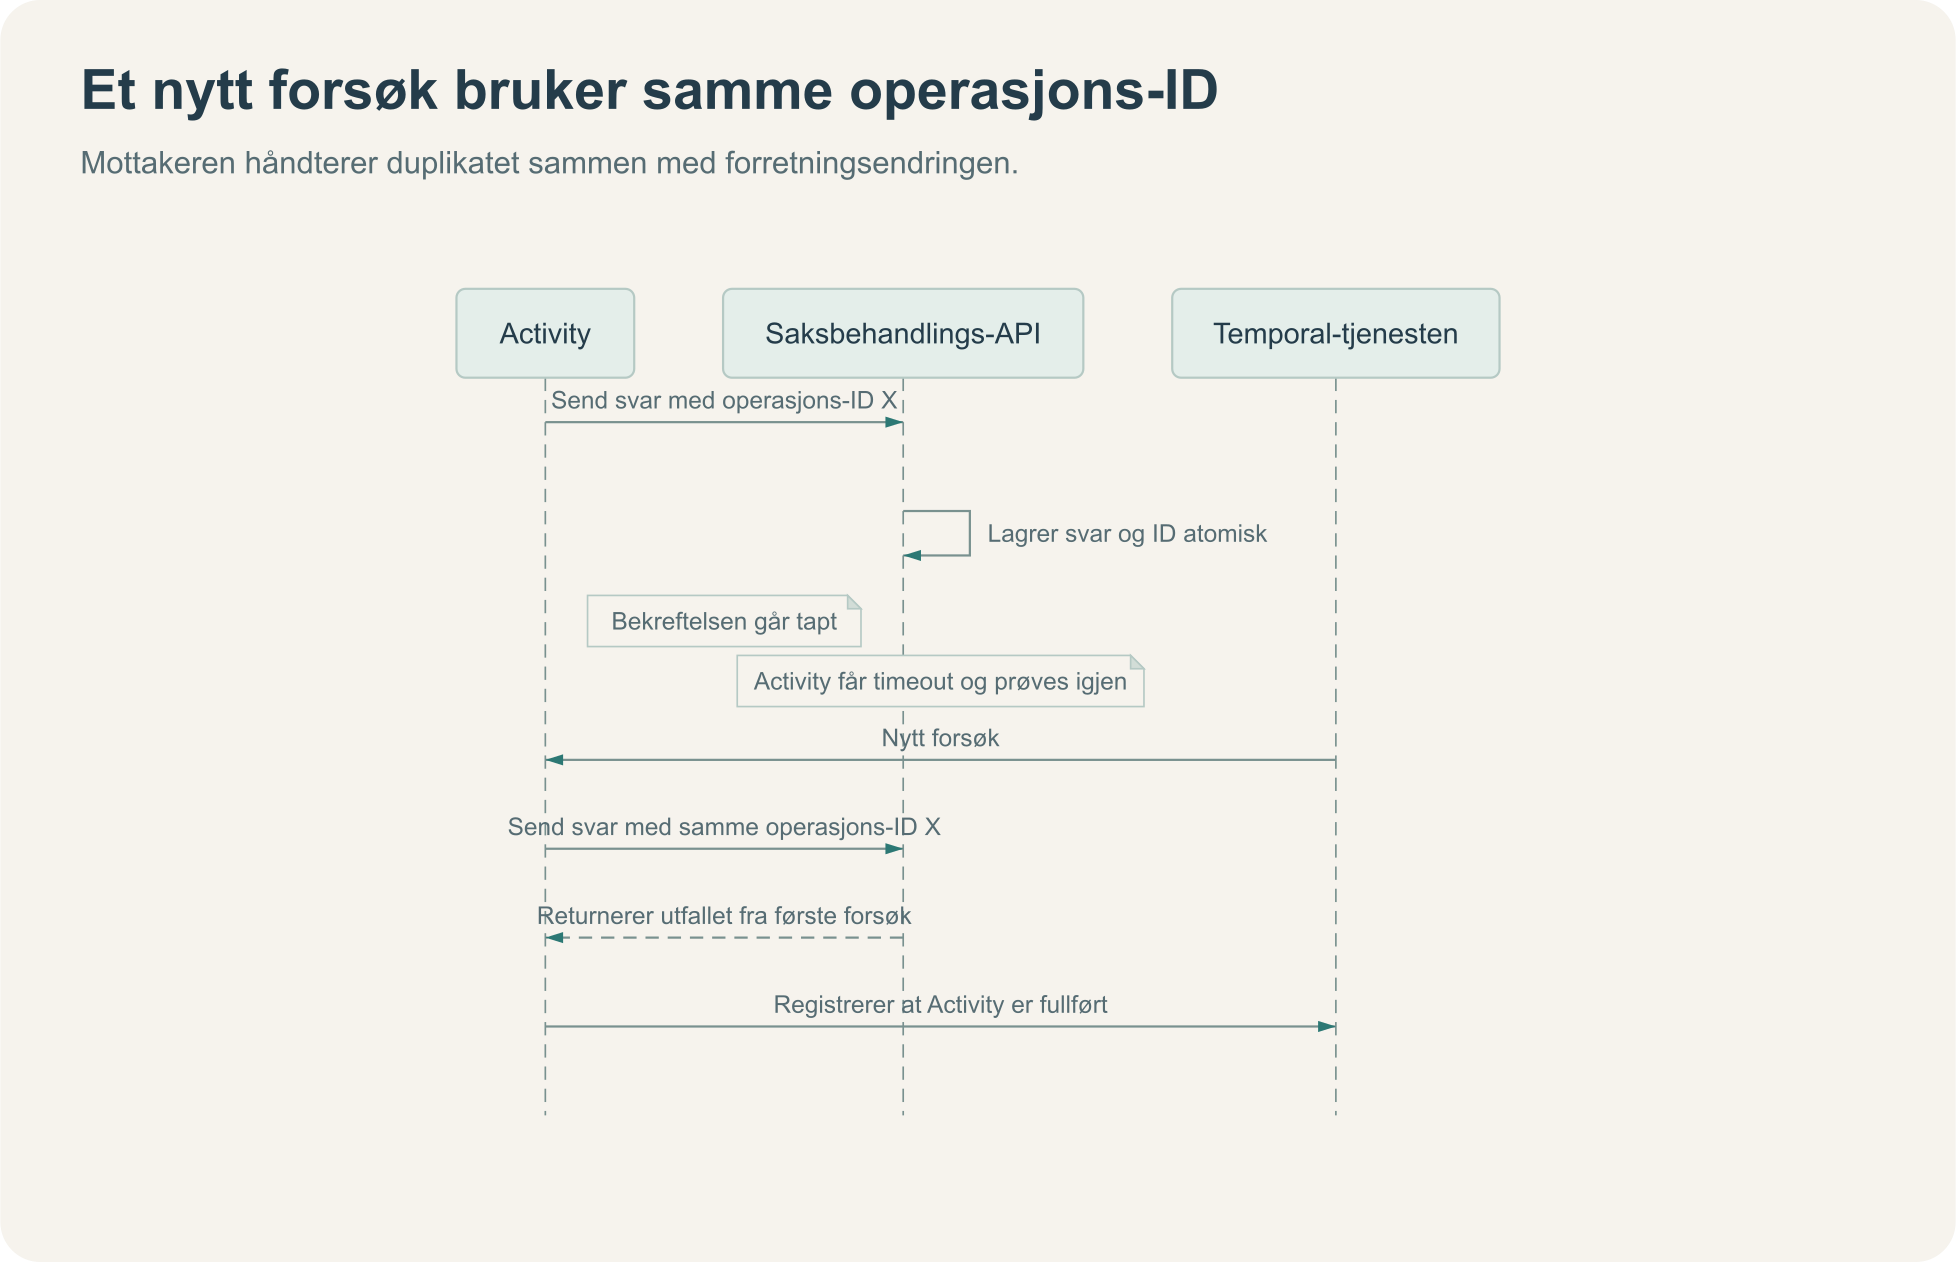
Hvis saksbehandlings-API-et mangler støtte for operasjons-ID-er, må vi undersøke utfallet før vi sender på nytt. Et tapt svar kan bety at meldingen allerede er lagret. En automatisk retry kan da gi kunden samme svar to ganger.
En rad i en tabell med status sent løser heller ikke dette alene. Skriver vi statusen før API-kallet, kan vi merke svaret som sendt selv om sendingen feiler. Skriver vi statusen etterpå, kan prosessen krasje etter sendingen og før statusen lagres. De to systemene deler ingen transaksjon som får begge oppdateringene til å skje samlet.
Siden vår egen status ikke gir et sikkert svar, må vi undersøke saken i saksbehandlingssystemet før vi prøver igjen. Hvis meldingshistorikken inneholder en referanse som identifiserer akkurat dette svarforsøket, kan vi kontrollere om svaret allerede er lagret. Finner vi det, kan kjøringen fortsette uten en ny sending. Hvis vi fortsatt ikke kan fastslå utfallet, må kjøringen stoppe og overlate avklaringen til et menneske.
Jeg vil gjerne kunne stole på retries. Det krever at operasjonen tåler dem, og at forsøkene har grenser. En midlertidig nettverksfeil og et permanent avslag på tilgang bør få ulik behandling. Temporals retry-policyer gir mekanismer for å styre dette.
Når en slik kjøring stopper opp, må noen kunne finne ut hva som har skjedd. Det kan være en saksbehandler som lurer på hvorfor svaret uteblir, eller en utvikler som undersøker en feil. Begge trenger å se hvor agenten står, og hva den venter på.
Jeg likte å kunne åpne en kjøring og se stegene den hadde vært gjennom. Temporal lagrer en hendelseshistorikk som gjør det mulig å undersøke fremdriften. I tillegg vil jeg knytte kjøringen til saks-ID og registrere hvilken modell- og promptversjon som laget forslaget.
For supportagenten kan et forenklet utdrag fra historikken se slik ut:
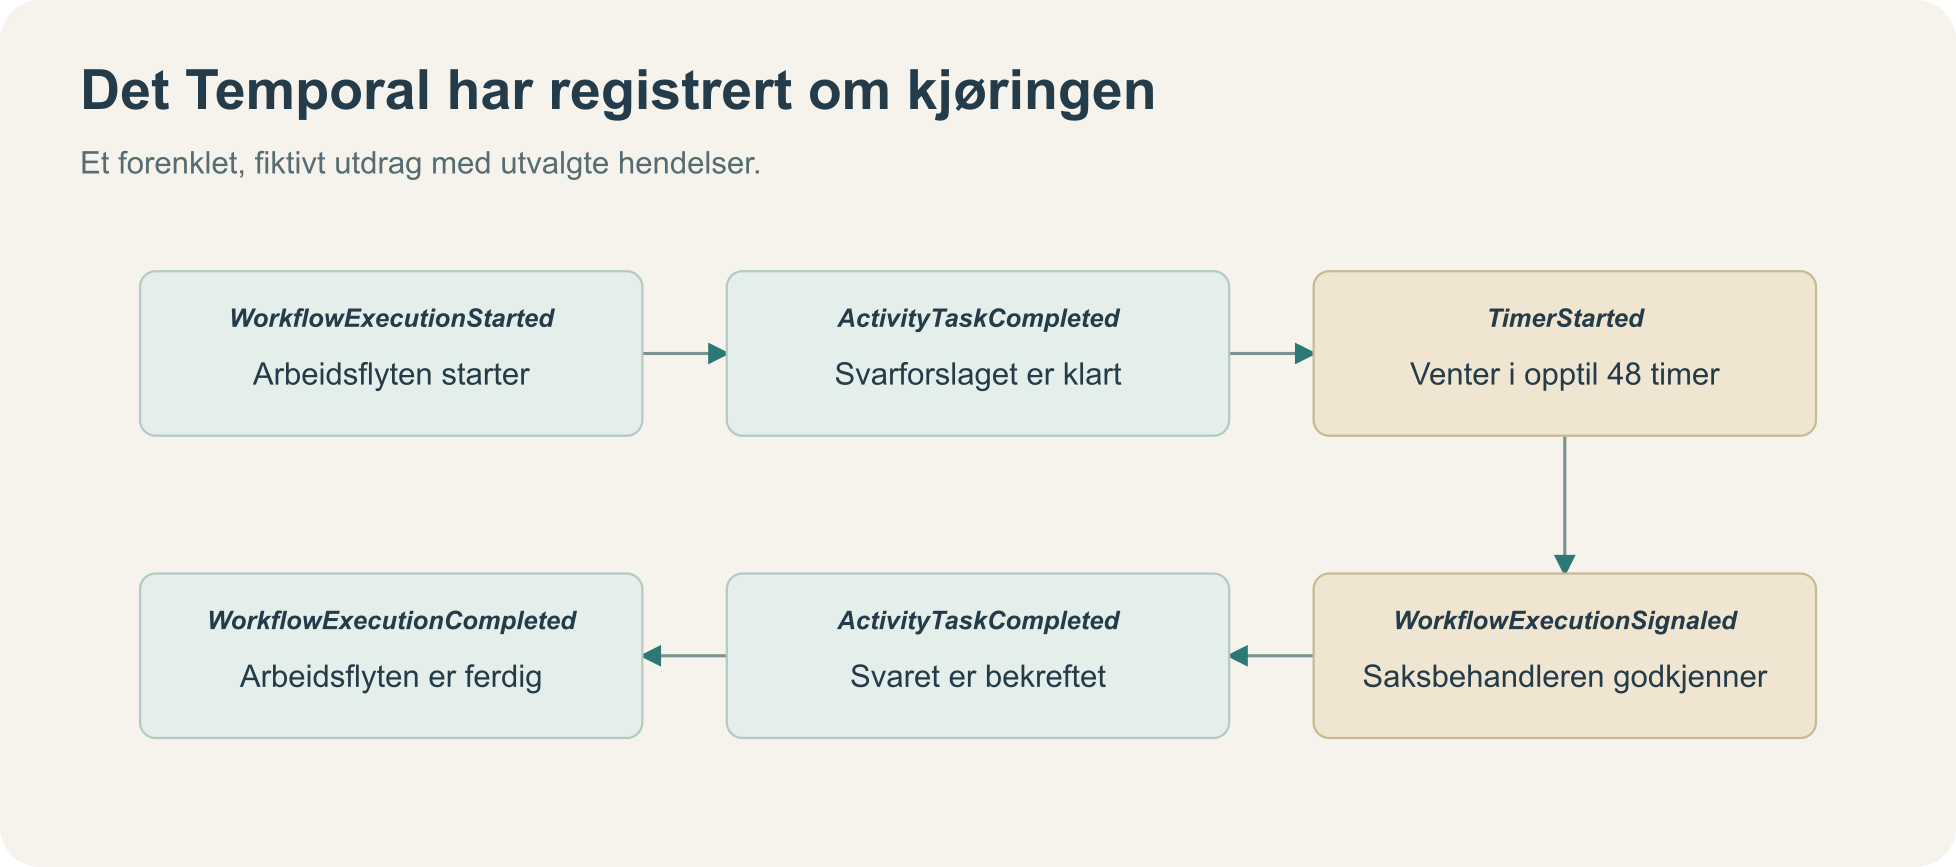
Historikken viser hva Temporal har registrert. Hvis sendingen lyktes uten at bekreftelsen nådde frem, må vi fortsatt kontrollere utfallet i saksbehandlingssystemet, slik vi beskrev i forrige del. Produktet trenger også egne kontroller for å stoppe og reparere arbeid. Brukeren skal kunne lukke nettleseren uten å kansellere kjøringen. Kansellering kan heller ikke trekke tilbake et svar som allerede er sendt.
Siden kjøringen kan vare over flere deployer av systemet, må vi planlegge for versjonering av workflow-koden og endringer i modell og prompt. Vi må også velge hva historikken får inneholde, så vi ikke lekker konfidensiell informasjon.
Når teamet vil ta en slik motor i bruk, må noen også eie innføringen og driften. I kundeprosjektet var innføring av en felles durable execution engine en større beslutning enn teamet vårt kunne ta alene. En sentral løsning ville kreve avklaringer om drift og sikkerhet, og prioritering hos andre team. Vi hadde behov som måtte løses før den beslutningen var på plass. Derfor bygde vi den minste grunnmuren vi trengte på PostgreSQL, Celery og eksisterende workers.
Vi jobber iterativt og bygger nok til å dekke behovet vi har. Det lar oss opprettholde utviklingstempoet vårt med færre avhengigheter til andre team. Samtidig eier vi databasemigrasjonene og backend-logikken som får dette til å fungere. Vi må også vedlikeholde køhåndtering, retries og gjenopptakelse.
Den kostnaden er en del av valget. Vi opprettholder lokal handlefrihet mens organisasjonen avklarer en felles plattform. Dersom flere team bygger tilsvarende mekanismer, får organisasjonen flere løsninger å forvalte. Samtidig øker insentivet til å samle dette som en felles tjeneste under plattformteamets ansvar. Jeg er ganske sikker på at flere utviklere i Norge kjenner seg igjen i denne avveiningen.
En slik felles tjeneste kan for eksempel være self-hostable Temporal. Da må plattformteamet selvfølgelig eie lagring og sikkerhet, og ha rutiner for overvåking og gjenoppretting. Selvhostingsguiden beskriver hva dette driftsansvaret innebærer.
Jeg har forståelse for at plattformteam har lange backlogger med annet som må gjøres. Samtidig tror jeg behovet for durable execution vil øke når flere produktteam bygger agentiske arbeidsflyter. Jeg har begynt å merke det i arbeidet selv. Det taler for å diskutere grunnmuren før mange team har blitt avhengige av hver sin løsning.
For å finne ut hva dere trenger fra en felles plattform, ville jeg startet med én konkret arbeidsflyt. Skriv ned hva den skal tåle, og undersøk hva dagens løsning faktisk håndterer. Bruk gjerne supportcaset som utgangspunkt:
Ta resultatene med til teamet som eier plattformen. Da kan dere diskutere konkrete garantier og ansvar, med et tydelig bilde av hva eksisterende infrastruktur dekker. Det gir også et bedre grunnlag for å vurdere hva produktteamet bør bygge selv mens en felles løsning prioriteres.
Supportcaset er fiktivt. Erfaringsgrunnlaget er et personlig prosjekt og en anonymisert kundeleveranse. Interne kilder er utelatt for å bevare anonymiteten.

Magnus bygger AI i Capra, nå på Gjensidiges «Hei, huset!». Han er opptatt av AI som fungerer i praksis og av å rigge tverrfaglige team for en AI-first arbeidsform. Det skriver han om og holder foredrag om.